September 21, 2026
世界模型公司保密背后的信息不对称
- 核心公司:AMI Labs(Yann LeCun)和 World Labs(Fei-Fei Li)获高额融资但极少披露产品
- 保密原因:公开应用方向易引来OpenAI等竞争,当前融资环境下无需急于商业化
- 判断框架:空间智能应用广泛却路径模糊,需谨慎评估其真实商业化能力
Created by 凌枫
Latest multimodal and open-source AI model names, architectures, and terminology
Explore the latest content tracked by Multimodal Model Tracker
Cal-OPD 通过正负特权干预估计教师自偏差区域,仅保留超出该区域的教师-学生差异作为信号,保留约52-65%原始差异却在数学推理基准上持续优于标准OPD。
Paint-Anything 提出 hex-prompt 接口,通过对象级颜色监督实现任意 24 位 Hex 色值控制。其 Paint-500K 数据集结合纯色锚点训练,并在 ACBench 基准上使 FLUX.2-4B 的 T2I 和编辑得分分别提升 85.3% 与 28.3%。
文章仅包含用户主观偏好讨论,未见Grok 4.7任何正式规格、权重、基准或官方公告。 提及延迟发布与模型比较,但均为个人体验而非可验证发布信息。
MoME 将每个 token 的单一记忆行替换为 M 个槽位的混合体,并通过隐藏状态的 learned gate 实现上下文感知的稀疏查找。 在 Llama-3、Qwen3 等骨干上的等参数预训练实验中,MoME 优于 Value Embedding 等基线,同时展现更好的内存规模化趋势与语义可解释性。
LynnReal-Omni采用共享多模态扩散Transformer,同时接收文本、姿态、3D渲染和游戏记录,完成主体发现与跨镜头关联。每个镜头最多提取6个可复用主体,提升角色一致性与可控生成。
MintAct 系列视觉语言模型在 2B/4B/8B 规模下,统一 UI 定位、多步导航(移动、桌面、网页)和视觉工具调用,匹配领域专精模型性能,并在 OSWorld-Verified 基准达到 48.9 SOTA。
瑞创在CIOE 2026发布Infrared Vision-Language Model,专为热成像设计,支持超500万多模态红外数据样本,内置红外视觉编码器捕捉温度分布与热特征。模型针对气体检测(甲烷、二氧化硫等)、电气巡检及周界监控训练,能解析气体羽流模式与背景干扰,实现从信号捕获到异常自动识别的跃升。支持边缘AI部署于Falcon 500芯片,降低延迟并保护敏感数据。
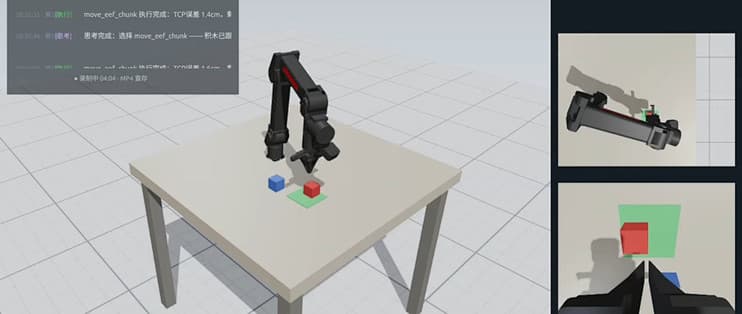
朱玉可演讲指出,当前动作预测聚焦模仿学习(imitation learning),通过数据集训练VLA模型实现跨任务泛化,机器人似在复刻语言大模型路径。
Qwen3.8-Flash-Next 与 Qwen3.8-27B 对比显示 125B 总参数、6B 激活参数 的稀疏设计。
宇树科技开源具身基座模型通过统一动作空间与RVQ实现动作token化。
GPT-6 Astra 据称通过已知密钥列表和打字错误修正,解开了未解的一战德军无线电密文。
三层选型框架按参数规模划分:
VimRAG以**动态记忆图(DAG)**替代传统线性上下文,每个节点封装文本摘要+视觉证据+拓扑位置,支持推理路径回溯与试错。
前 OpenAI 研究员 Diogo Almeida 推出 Jev 模型,采用“reinforcement learning from calibrated decisions”训练,输出概率而非文本,解决 LLM 幻觉与自动化难题。开发者因其低成本、高速度和真实置信度,快速用于分类、路由和代理监控,被称作“System One model”。
PrismML 以 ternary weights(+1/-1/0)将 Qwen3.8 27B 压缩 9-10 倍至 Bonsai 2 27B,保留 98% 基准性能,可运行于消费级 PC。 这暗示更大模型压缩后更易保留智能,但文章未提供第三方独立验证,需关注其开源权重与实际端侧部署效果。
ZDTaichu5.0-9B已开源,9B参数支持任意分辨率视觉输入,重点强化空间感知与具身规划。
工业场景已验证取件搬运等任务规划,但真实机器人闭环证据仍待进一步披露。