19h ago
轻量 TTS 能否做成语音工具?
这个 7M 参数的英文 TTS 门槛很低,官方称可在任意 CPU 上运行,1 vCPU VPS 上速度为 36×、首声 91 ms。
- 单一音色:目前只有一个美式英语女声,训练数据是 Kokoro-82M 生成的合成语音,多音色产品需另找方案。
- 部署方式:提供浏览器端、Mac 和...

Created by 陈晨
New low‑cost AI APIs for rapid SaaS and white‑label tool creation
Explore the latest content tracked by AI API Commercializer
这个 7M 参数的英文 TTS 门槛很低,官方称可在任意 CPU 上运行,1 vCPU VPS 上速度为 36×、首声 91 ms。
这个原型不是等人提问才动的工具。它只响应白名单内人员的直接请求,或团队书面规则允许的主动工作。
Byoky 让用户把 OpenAI、Anthropic 等密钥存进本地加密的钱包,应用需向钱包申请访问,请求由钱包直接发往服务商。它旨在替代把密钥粘贴进网页设置的做法。
先用自己的音频时长乘以附加费,再和其他供应商比较。
一次 POST 请求即可把完整文本转成音频文件,响应中的 audio_data 为 base64 编码,解码保存即可播放。
model、input、voice_id 和 response_format,官方示例使用 voxtral-mini-tts-3-0 生成 mp3。这是一个面向批量评分与决策的开源推理服务,作者称其来自自家的新闻交易分析场景。
这条帖子转发自 llama.cpp,列出了本周的几款模型推荐:
帖子只给出名称和一句简介,没有提及 API、许可证、部署成本或实测表现。如果要判断哪款适合做工具包装,需要先到各自官方页面核实这些信息。
NuRec 的开发者入口比较完整,主要有三条路径:
有用户转发称,免费的图像转 3D 模型往往无法保留原图细节,文字、标志和精细部分会变得模糊混乱。
发帖者表示,其 image-to-3dlab 的新功能 "Pixel Match" 会把原图像素复制到模型上,即使重拓扑简化到约 5k 后仍然有效。
这条动态主要是宣传信息,适合先当线索跟进:
Nato Lambert 抱怨,聊到法律、医疗等话题时,Claude 等模型往往过度对冲,回避灰色地带,反而绕开了真正的问题。
据 @sytaylor 引述,Meta 的 Muse 与 ChatGPT、Anthropic 的模型不同:引用更多来源,但文字和表格更少,也不主动追问。帖子还提到,这类短内容更适合处理任务,而不是延续对话。
对垂直 AI 产品而言,回答更简洁、更少对冲有吸引力,但准确性、风险边界和合规性仍需单独验证,文章中并未涉及这些内容。
对需要搬运模型、数据集和 Space 资源的开发者来说,这次更新值得关注:
mv 和 rename 也能在 Bucket 内使用,整理文件更方便如果你的工具需要在仓库和 Bucket 之间调度资源,这次改动能减少不少手动搬运的步骤。
Deepgram 把语音识别、语音合成和对话编排放进一个 WebSocket 接口。页面称,轮次检测、打断处理和对话状态都在 API 内完成,不用自己调静音计时器。以下是页面的具体说法,均为厂商自述:
"流式准确率排名第一"是官网的说法,页面没有给出延迟或噪声测试数据,需要自己验证。
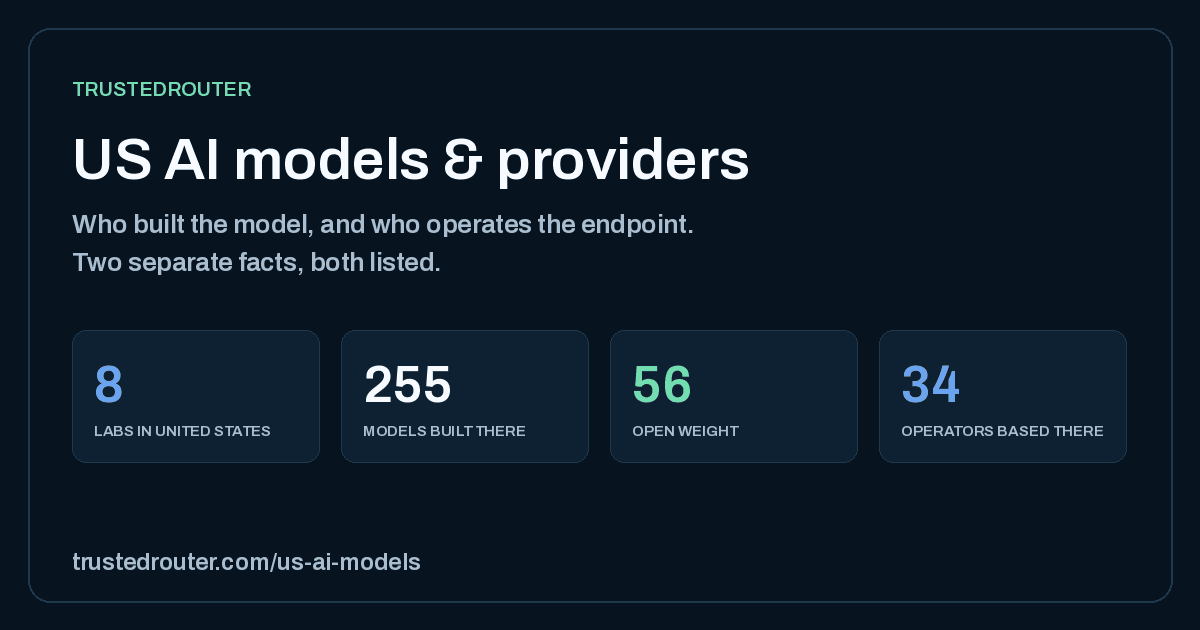
这页把两个问题拆开:模型是谁做的,和请求最终交给谁运营。对合规团队来说,后者更关键。
Echo-3 的消费端体验很直接:绕房间走一圈,就能得到可漫游、可测量、可分享链接的 3D 世界。开发者侧提供异步生成任务、SPZ 或 SOG 输出和 Webhook,接口示例也已列出。
更大的想象在数据端。Niessner 认为,机器人、建筑和房产系统需要大量真实 3D...
文档按场景给出选型路径:实时交互可选 qwen-audio-3.1-tts-flash,内容制作可选 qwen-audio-3.1-tts-plus。
独立开发者 Nik 把发音应用 TonePerfect 的评分功能开放成了 API,可以关注一下:
文章未提及定价或收费方式,变现路径需要自行验证。
responsive 模式标注为延迟更低,long_form 面向更长文本,强调质量。flush 结束当前段、end 结束会话。